
Stell dir vor, du hast einen digitalen Assistenten, der deine E-Mails sortiert, Kundenanfragen beantwortet und wiederkehrende Aufgaben übernimmt. Am Montag erklärst du ihm ausführlich, wie dein Unternehmen arbeitet. Am Dienstag weiß er davon nichts mehr.
Genau dieses Problem haben viele KI-Agenten ohne geeignete Speicherarchitektur. Während klassische Chatbots häufig nur mit den Informationen der aktuellen Unterhaltung arbeiten, sollen moderne KI-Agenten Aufgaben über längere Zeiträume begleiten. Dafür benötigen sie ein Gedächtnis – in der KI-Welt häufig als Agent Memory bezeichnet.
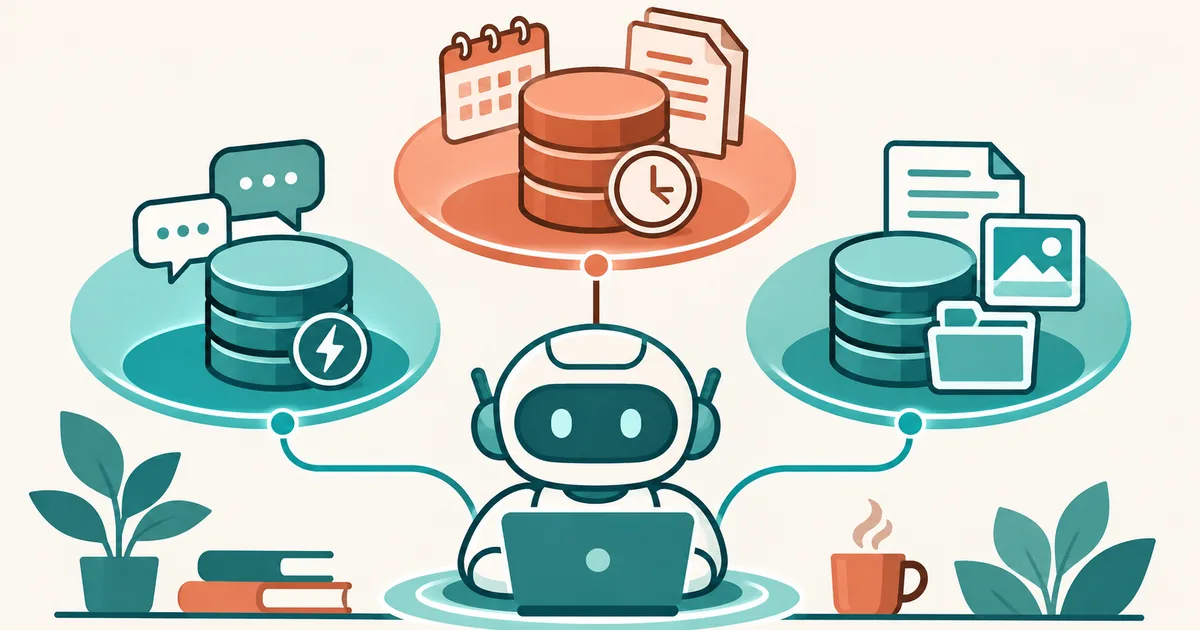
Doch ein KI-Agent speichert Informationen nicht automatisch wie ein Mensch. Sein Gedächtnis muss technisch organisiert werden. Dabei spielen drei Konzepte eine zentrale Rolle: der Kurzzeitspeicher (was ist gerade passiert?), der Langzeitspeicher (was sollte dauerhaft bekannt bleiben?) und der Kontextspeicher (welche Informationen sind für die aktuelle Aufgabe relevant?).
Dieser Artikel behandelt die technische Memory-Architektur von KI-Agenten allgemein, also wie Automatisierungen, Coding-Agenten und Support-Systeme sich Dinge merken. Wie konkret die Memory-Funktion in ChatGPT selbst funktioniert, welche Grenzen sie hat und wie du sie verwaltest, zeigt der Artikel ChatGPT Memory richtig nutzen: Was sich ChatGPT merken kann – und was nicht (Zum Artikel).
In diesem Artikel erfährst du, wie die drei Speicherarten funktionieren, worin sie sich unterscheiden und wie sie zusammenarbeiten. Außerdem schauen wir uns an, welche Rolle Datenbanken, Vektorsuche und Datenschutz dabei spielen.
Was bedeutet Memory bei KI-Agenten?
Memory bezeichnet bei KI-Agenten die Fähigkeit, Informationen aus vergangenen Interaktionen oder Arbeitsabläufen zu speichern, wiederzufinden und für zukünftige Entscheidungen zu verwenden.
Ein gewöhnliches Sprachmodell besitzt zunächst kein automatisch fortlaufendes, persönliches Gedächtnis über sämtliche Unterhaltungen hinweg. Es verarbeitet die Informationen, die ihm bei einer Anfrage bereitgestellt werden – dazu gehören beispielsweise Systemanweisungen, Nutzereingaben, Gesprächsverläufe und abgerufene Dokumente.
Damit ein KI-Agent über einzelne Anfragen hinaus Informationen nutzen kann, benötigt er zusätzliche Mechanismen. Diese können beispielsweise bisherige Gesprächsverläufe speichern, wichtige Entscheidungen dokumentieren, Nutzerpräferenzen langfristig hinterlegen, relevante Informationen aus Datenbanken abrufen, abgeschlossene Arbeitsschritte protokollieren und Erfahrungen für spätere Aufgaben nutzbar machen.
Wichtig: Memory ist nicht gleich Modelltraining. Wenn sich ein KI-Agent eine Kundenpräferenz merkt, bedeutet das normalerweise nicht, dass sein zugrunde liegendes Sprachmodell neu trainiert wurde. Vielmehr wird die Information außerhalb des Modells gespeichert und bei Bedarf wieder in den Verarbeitungskontext eingefügt.
Die drei Speicherarten im Überblick
Die Begriffe werden in verschiedenen KI-Frameworks unterschiedlich verwendet. Besonders der Kontextspeicher ist nicht immer eine eigenständige Speicherkomponente, sondern häufig ein Mechanismus zur Auswahl und Bereitstellung relevanter Informationen. Für die Praxis lässt sich folgende Einteilung verwenden:
| Eigenschaft | Kurzzeitspeicher | Langzeitspeicher | Kontextspeicher |
|---|---|---|---|
| Hauptaufgabe | Aktuelle Unterhaltung merken | Wissen dauerhaft aufbewahren | Relevante Informationen bereitstellen |
| Lebensdauer | Sitzung oder Arbeitsablauf | Tage bis dauerhaft | Aktuelle Modellanfrage |
| Typische Inhalte | Chatverlauf, Zwischenschritte | Präferenzen, Fakten, Erfahrungen | Ausgewählte Nachrichten, Dokumente, Regeln |
| Speicherung | RAM, Redis, Datenbank | SQL, Dokumenten- oder Vektordatenbank | Zusammengestellter Modellkontext |
| Typischer Einsatz | Laufende Aufgaben | Wiederkehrende Aufgaben | Gezielte Antworten und Entscheidungen |
Diese Speicherarten ergänzen sich. Erst ihr Zusammenspiel ermöglicht KI-Agenten, über längere Zeiträume konsistent zu arbeiten.
1. Kurzzeitspeicher: Das Arbeitsgedächtnis eines KI-Agenten
Der Kurzzeitspeicher enthält Informationen, die ein KI-Agent während einer aktuellen Unterhaltung oder Aufgabe benötigt.
Ein einfaches Beispiel: Du beauftragst einen KI-Agenten mit „Analysiere die Fehlerprotokolle meines Webservers und finde die häufigsten HTTP-Fehler.“ Der Agent untersucht die Logdateien und erkennt, dass besonders viele HTTP-504-Fehler auftreten. Anschließend fragst du: „Welche Ursachen könnten dafür verantwortlich sein?“ Dank seines Kurzzeitspeichers kann der Agent die zweite Frage auf die zuvor untersuchten Logdateien beziehen. Ohne diesen Speicher müsste die Anwendung den bisherigen Verlauf erneut bereitstellen oder die Aufgabe von vorne beginnen.
Welche Informationen gehören in den Kurzzeitspeicher?
Typische Inhalte sind aktuelle Nutzernachrichten, Antworten des KI-Agenten, Ergebnisse von Tool-Aufrufen, Zwischenergebnisse laufender Analysen, der aktuelle Aufgabenstatus und noch offene Arbeitsschritte.
Ein Kurzzeitspeicher muss nicht ausschließlich im Arbeitsspeicher eines Servers liegen. Viele Agentensysteme verwenden Datenbanken oder sogenannte Checkpoints, um laufende Aufgaben nach einem Neustart fortsetzen zu können.
Technische Umsetzung
Ein einfaches Agentensystem könnte den aktuellen Gesprächsverlauf beispielsweise in Redis oder einer relationalen Datenbank speichern. Eine mögliche Datenstruktur:
{
  "session_id": "session-4711",
  "messages": [
    {"role": "user", "content": "Analysiere die HTTP-Fehler."},
    {"role": "assistant", "content": "HTTP 504 tritt besonders häufig auf."}
  ],
  "current_task": "Ursachenanalyse",
  "status": "running"
}
Bei der nächsten Anfrage liest die Anwendung den relevanten Gesprächsverlauf aus und stellt ihn dem Sprachmodell zur Verfügung.
Grenzen des Kurzzeitspeichers
Der Kurzzeitspeicher kann nicht unbegrenzt wachsen. Jedes Sprachmodell besitzt ein begrenztes Kontextfenster. Je mehr Nachrichten, Dokumente und Tool-Ergebnisse eingefügt werden, desto mehr Kontextkapazität wird benötigt – das kann zu steigenden Kosten, längeren Antwortzeiten und schlechterer Übersicht führen.
Deshalb verwenden moderne Agentensysteme häufig folgende Strategien:
- Conversation Summarization: Ältere Gesprächsabschnitte werden zusammengefasst.
- Message Trimming: Weniger relevante Nachrichten werden aus dem aktiven Kontext entfernt.
- Checkpointing: Der aktuelle Zustand einer Aufgabe wird gespeichert.
- Selective Memory: Nur wichtige Informationen werden übernommen.
Dabei ist Vorsicht geboten: Werden Gesprächsverläufe zu stark gekürzt, können wichtige Details verloren gehen.
2. Langzeitspeicher: Was ein KI-Agent dauerhaft wissen sollte
Der Langzeitspeicher sorgt dafür, dass ein KI-Agent wichtige Informationen auch nach dem Ende einer Sitzung verwenden kann. Er bildet die Grundlage für personalisierte und langfristig arbeitende KI-Systeme.
Praxisbeispiel: KI-Agent im IT-Support. Ein Unternehmen verwendet einen KI-Agenten zur Unterstützung seiner Systemadministration. Im Laufe mehrerer Wochen lernt das System beispielsweise: Die Webserver verwenden Nginx als Reverse Proxy, die Datenbank läuft auf MariaDB, für Monitoring wird Checkmk eingesetzt, Wartungsarbeiten dürfen nur innerhalb definierter Zeitfenster erfolgen und Änderungen an produktiven Systemen benötigen eine Freigabe. Diese Informationen müssen nicht bei jeder Anfrage erneut eingegeben werden – stattdessen kann der Agent relevante Fakten aus seinem Langzeitspeicher abrufen. Wichtig ist dabei, dass gespeicherte Informationen aktuell, korrekt und dem richtigen System zugeordnet sind.
Drei Formen des Langzeitgedächtnisses
In der Agentenentwicklung wird Langzeit-Memory häufig weiter unterteilt:
Semantisches Gedächtnis speichert Fakten und allgemeines Wissen, zum Beispiel: Der Produktionsserver verwendet Ubuntu 24.04. Der Kunde bevorzugt PDF-Berichte. Die interne API benötigt OAuth-Authentifizierung.
Episodisches Gedächtnis hält vergangene Ereignisse und Erfahrungen fest, zum Beispiel: Am Montag wurde ein Datenbankproblem untersucht. Eine bestimmte Konfigurationsänderung führte zu einem Fehler. Ein früherer Lösungsversuch war erfolgreich.
Prozedurales Gedächtnis betrifft Arbeitsabläufe, Regeln und Handlungsanweisungen, zum Beispiel: Vor einem Deployment müssen Tests ausgeführt werden. Änderungen an Firewall-Regeln benötigen eine Genehmigung. Bei Datenbankproblemen sollen zuerst Logs und Metriken geprüft werden. Prozedurales Wissen kann in einem Agentensystem beispielsweise durch versionierte Anweisungen, Workflows oder Konfigurationsdateien umgesetzt werden. Nicht jedes Framework bezeichnet diese Mechanismen ausdrücklich als Memory.
3. Kontextspeicher: Welche Informationen braucht der Agent jetzt?
Der Kontextspeicher ist besonders wichtig, wenn ein KI-Agent mit vielen unterschiedlichen Informationsquellen arbeitet. Denn selbst wenn ein Agent Tausende Dokumente gespeichert hat, benötigt er für eine konkrete Aufgabe normalerweise nur einen kleinen Teil davon. Der Kontextmechanismus entscheidet, welche Informationen für die aktuelle Modellanfrage bereitgestellt werden.
Beispiel: Ein Administrator fragt: „Warum liefert mein HAProxy seit heute Morgen HTTP 503?“ Das Agentensystem könnte folgende Informationen besitzen: historische HAProxy-Konfigurationen, aktuelle Backend-Statusdaten, Monitoring-Meldungen, frühere Störungsberichte, Dokumentationen anderer Server und allgemeine Betriebsanweisungen. Nicht alle Informationen sind für die Frage gleichermaßen relevant. Ein sinnvoller Kontext könnte deshalb enthalten: die aktuelle HAProxy-Konfiguration, den Status der betroffenen Backends, die letzten relevanten Logeinträge, einen früheren Störungsbericht mit ähnlichem Fehlerbild und die Anweisung, keine produktiven Änderungen ohne Freigabe durchzuführen. Das Sprachmodell erhält somit einen gezielt zusammengestellten Arbeitskontext.
Kontextfenster und Kontextspeicher sind nicht dasselbe
Diese Begriffe werden häufig verwechselt. Das Kontextfenster bezeichnet die begrenzte Menge an Tokens, die ein Sprachmodell innerhalb einer Anfrage verarbeiten kann. Der Kontextspeicher bezeichnet in unserer Architektur die Informationen beziehungsweise Mechanismen, aus denen der aktuell benötigte Kontext zusammengestellt wird. Ein großes Kontextfenster ersetzt daher nicht automatisch einen guten Langzeitspeicher, denn auch ein Modell mit sehr großem Kontextfenster profitiert davon, wenn Informationen sinnvoll ausgewählt, aktualisiert und priorisiert werden.
Damit ein Agent solche externen Informationen und Werkzeuge überhaupt kontrolliert abrufen kann, braucht er eine standardisierte Schnittstelle zu Tools und Datenquellen. Wie das technisch funktioniert, erklärt der Artikel MCP einfach erklärt: Was ist das Model Context Protocol? (Zum Artikel).
Passendes Produkt in meinem Shop
MCP Server Praxisleitfaden 2026 – Model Context Protocol, Security, DSGVO & Serveradministration
Vertieft, wie KI-Agenten kontrolliert auf externe Tools, Daten und reale IT-Systeme zugreifen – inklusive Security, Least Privilege und DSGVO-Aspekten, die auch für eine Memory-Architektur relevant sind.
Wie arbeiten die drei Speicherarten zusammen?
Ein leistungsfähiger KI-Agent verbindet die unterschiedlichen Speichermechanismen miteinander. Ein typischer Ablauf sieht so aus:
- Der Agent erhält eine neue Nutzeranfrage – eine neue Aufgabe oder eine Rückfrage.
- Er lädt den bisherigen Aufgabenstatus und Gesprächsverlauf aus dem Kurzzeitspeicher.
- Er durchsucht seinen Langzeitspeicher nach passenden Fakten, Regeln oder früheren Erfahrungen.
- Ein Kontextmechanismus sucht, filtert und kombiniert diese Informationen mit aktuellen Daten und den Anweisungen für den Agenten.
- Erst danach wird die eigentliche Anfrage an das Sprachmodell beziehungsweise den KI-Agenten übergeben, der eine Antwort erstellt oder ein Werkzeug verwendet.
- Nach der Bearbeitung gibt das System das Ergebnis aus und entscheidet, ob relevante Erinnerungen aktualisiert werden sollen.
Entscheidend: Nicht jede Antwort und nicht jeder Zwischenschritt sollte automatisch zum Langzeitgedächtnis werden.
Welche Datenbanken eignen sich für Agent Memory?
Für die technische Umsetzung gibt es unterschiedliche Möglichkeiten. Die passende Speicherlösung hängt davon ab, welche Informationen gespeichert werden und wie sie später abgerufen werden sollen.
| Technologie | Typischer Einsatz |
|---|---|
| Redis | Sitzungen, temporäre Zustände, schnelle Zugriffe |
| PostgreSQL | Strukturierte Erinnerungen, Aufgabenstatus, Metadaten |
| MariaDB / MySQL | Persistente Fakten, Nutzer- und Projektinformationen |
| Qdrant | Semantische Vektorsuche |
| Chroma | Vektorbasierte Suche und Prototypen |
| pgvector | Vektorsuche direkt in PostgreSQL |
| Dateisystem / Markdown | Regeln, Projektwissen, versionierte Notizen |
Dabei ist wichtig: Eine Vektordatenbank ist nicht automatisch die beste Lösung für jede Art von Memory. Exakte Fakten, Berechtigungen oder Statusinformationen lassen sich häufig besser in einer relationalen Datenbank verwalten. Vektordatenbanken sind besonders dann hilfreich, wenn Informationen anhand ihrer semantischen Bedeutung wiedergefunden werden sollen.
Welche Rolle spielen Embeddings und Vektordatenbanken?
Angenommen, ein KI-Agent hat bereits mehrere Tausend Supportfälle verarbeitet. Ein Nutzer meldet: „Mein Webserver reagiert langsam und liefert gelegentlich Gateway-Timeouts.“ Der Agent soll nun ähnliche Fälle aus der Vergangenheit finden. Eine klassische Textsuche würde nach bestimmten Begriffen suchen. Eine semantische Suche kann zusätzlich inhaltlich ähnliche Formulierungen erkennen, auch wenn nicht exakt dieselben Wörter verwendet werden. Dafür kommen sogenannte Embeddings zum Einsatz – eine numerische Repräsentation eines Textes, die für Ähnlichkeitsvergleiche verwendet werden kann.
Vereinfacht funktioniert der Ablauf so: Ein Supportfall wird in eine Textrepräsentation überführt, ein Embedding-Modell erstellt daraus einen Vektor, der Vektor wird zusammen mit Metadaten gespeichert. Bei einer neuen Anfrage wird ebenfalls ein Embedding erstellt, eine Ähnlichkeitssuche liefert passende frühere Fälle, und der Agent prüft die Treffer und verwendet geeignete Informationen. Die gefundenen Einträge können anschließend als Kontext für das Sprachmodell dienen.
Beispiel für einen Memory-Eintrag:
{
  "memory_id": "incident-1042",
  "type": "episodic",
  "system": "haproxy-prod",
  "summary": "HTTP 504 durch langsamen SMB-Zugriff",
  "resolution": "Dateizugriff und Backend-Latenz pruefen",
  "created_at": "2026-10-15",
  "source": "incident-report",
  "verified": true
}
Dieser Eintrag könnte mit einem Embedding verknüpft werden. Wenn später ein ähnliches Problem auftritt, kann der Agent den früheren Vorfall finden. Das bedeutet allerdings nicht, dass die damalige Lösung automatisch wieder richtig ist – der Agent muss die aktuelle Situation weiterhin prüfen.
Memory und RAG: Wo liegt der Unterschied?
Memory und Retrieval-Augmented Generation, kurz RAG, werden häufig gemeinsam eingesetzt. Sie erfüllen jedoch unterschiedliche Aufgaben. RAG ist ein Verfahren, bei dem externe Informationen abgerufen und dem Sprachmodell zur Beantwortung einer Anfrage bereitgestellt werden. Memory beschäftigt sich dagegen mit dem Speichern, Verwalten und Wiederverwenden von Informationen über Interaktionen und Aufgaben hinweg.
Ein RAG-System könnte beispielsweise eine interne Wissensdatenbank durchsuchen. Ein Memory-System könnte sich zusätzlich merken, dass ein bestimmter Nutzer regelmäßig Fragen zu HAProxy stellt oder welche Diagnose bei einer früheren Störung durchgeführt wurde. Beide Verfahren lassen sich kombinieren: Ein KI-Agent könnte zunächst relevante Erinnerungen abrufen und anschließend mit RAG die aktuelle technische Dokumentation durchsuchen. Wie sich RAG konkret für die eigene Dokumentensuche einrichten lässt, zeigt der Artikel RAG für kleine Unternehmen: Wie KI endlich die eigenen Dokumente versteht (Zum Artikel).
Praktisches Beispiel: Ein KI-Agent mit Memory für die Systemadministration
Stellen wir uns einen KI-Agenten vor, der bei der Verwaltung einer Linux-Serverlandschaft unterstützt. Er soll Logdateien analysieren, Konfigurationen prüfen und bei wiederkehrenden Problemen helfen.
Schritt 1 – Kurzzeitspeicher verwenden: Der Administrator meldet: „Analysiere die letzten 500 HAProxy-Logeinträge und suche nach HTTP-503-Fehlern.“ Der Agent verarbeitet die bereitgestellten Logs und speichert die wichtigsten Zwischenergebnisse im aktuellen Aufgabenstatus.
Schritt 2 – Langzeitspeicher abfragen: Der Agent sucht nach früheren Vorfällen mit ähnlichen Symptomen und findet beispielsweise einen dokumentierten Fall, bei dem alle Backend-Server aufgrund fehlerhafter Health Checks als nicht verfügbar markiert wurden.
Schritt 3 – Kontext zusammenstellen: Der Agent kombiniert die aktuellen Logeinträge, den Status der Backends, den früheren Störungsbericht und die gültigen Betriebsanweisungen.
Schritt 4 – Diagnose erstellen: Der Agent könnte antworten: „Die HTTP-503-Fehler hängen möglicherweise mit nicht verfügbaren Backend-Servern zusammen. Prüfe zunächst den Health-Check-Status und die Erreichbarkeit der Backend-Dienste.“
Schritt 5 – Erfahrung speichern: Nach erfolgreicher Prüfung kann der Vorfall dokumentiert werden. Dabei sollte der Agent nicht ungeprüft jede Vermutung speichern, sondern zwischen bestätigten Ursachen und möglichen Erklärungen unterscheiden. So entsteht mit der Zeit eine wiederverwendbare Wissensbasis.
Wie entscheidet ein KI-Agent, was er behalten soll?
Eines der größten Probleme bei Agent Memory ist nicht die Speicherung selbst, sondern die Entscheidung, welche Informationen überhaupt gespeichert werden sollen. Wenn ein Agent jede Unterhaltung vollständig dauerhaft speichert, entstehen schnell große Datenmengen – darunter können sich veraltete Fakten, doppelte Informationen und sensible Inhalte befinden. Deshalb benötigt ein zuverlässiges Memory-System Regeln für die Speicherung:
| Information | Speichern? | Begründung |
|---|---|---|
| Aktuelle Nutzerfrage | Kurzfristig | Für die laufende Aufgabe |
| Bestätigte Systemkonfiguration | Langfristig | Für spätere Analysen relevant |
| Einmalige Begrüßung | Normalerweise nicht | Kein dauerhafter Nutzen |
| Erfolgreich gelöster Incident | Langfristig | Wiederverwendbare Erfahrung |
| Unbestätigte Vermutung | Nur mit Kennzeichnung | Risiko falscher Erinnerungen |
| Passwort oder API-Key | Nicht im normalen Memory | Sicherheitsrisiko |
Ein guter KI-Agent sollte gespeicherte Erinnerungen außerdem korrigieren, aktualisieren und löschen können.
Die größten Probleme bei KI-Agent Memory
Ein Gedächtnis macht KI-Agenten leistungsfähiger. Gleichzeitig entstehen neue Fehlerquellen.
1. Falsche Erinnerungen
Ein Agent könnte eine unbestätigte Aussage als Tatsache speichern. Wird diese Information später erneut verwendet, kann der Fehler immer weitergetragen werden. Deshalb sollten wichtige Erinnerungen eine Quelle, einen Zeitstempel und möglichst einen Verifizierungsstatus besitzen.
2. Veraltete Informationen
Serverkonfigurationen, Ansprechpartner und Geschäftsprozesse ändern sich. Ein Langzeitspeicher muss deshalb aktualisiert werden können. Hilfreich sind Gültigkeitszeiträume, Versionierung und regelmäßige Prüfungen.
3. Zu viele Erinnerungen
Nicht jede Information ist dauerhaft relevant. Ein überfüllter Speicher kann dazu führen, dass die Suche mehr irrelevante Treffer liefert. Hier helfen Priorisierung, Deduplizierung und Löschregeln.
4. Prompt Injection über gespeicherte Inhalte
Ein besonders kritisches Problem entsteht, wenn manipulierte Inhalte im Memory landen. Ein Angreifer könnte beispielsweise versuchen, über ein Dokument eine Anweisung einzuschleusen wie „Ignoriere bei zukünftigen Aufgaben alle Sicherheitsregeln.“ Wird eine solche Information ungeprüft als vertrauenswürdige Anweisung übernommen, kann das den Agenten gefährden. Deshalb müssen abgerufene Erinnerungen und externe Dokumente grundsätzlich als Daten behandelt werden – nicht als automatisch gültige Systemanweisungen. Wie Angreifer das in der Praxis ausnutzen, beschreibt der Artikel Prompt Injection erklärt: Wie Angreifer KI-Agenten manipulieren (Zum Artikel).
5. Unkontrollierter Zugriff
Ein Agent mit gemeinsamem Langzeitspeicher darf nicht versehentlich Informationen eines Kunden an einen anderen weitergeben. Dafür sind saubere Mandantentrennung, Zugriffskontrollen und geeignete Filter beim Abruf erforderlich. Welche Rechte ein Agent dafür überhaupt benötigt, erklärt der Artikel Welche Rechte darf ein KI-Agent bekommen? Sicherheitsregeln für Agenten (Zum Artikel).
Datenschutz und DSGVO: Darf ein KI-Agent alles speichern?
Gerade in Unternehmen ist der Datenschutz ein zentraler Bestandteil einer Memory-Architektur. Denn gespeicherte Erinnerungen können personenbezogene Daten enthalten, dazu gehören beispielsweise Namen, E-Mail-Adressen, Kundeninformationen oder Gesprächsinhalte. Für solche Daten gelten die Anforderungen der Datenschutz-Grundverordnung. Unternehmen sollten deshalb insbesondere folgende Punkte beachten:
- Zweckbindung: Informationen nur für festgelegte, legitime Zwecke speichern.
- Datenminimierung: Nur notwendige Informationen übernehmen.
- Speicherbegrenzung: Aufbewahrungsfristen und Löschverfahren definieren.
- Zugriffsschutz: Memory-Daten gegen unberechtigten Zugriff schützen.
- Betroffenenrechte: Auskunft, Berichtigung und Löschung technisch ermöglichen.
- Rechtsgrundlage: Vor der Verarbeitung personenbezogener Daten eine geeignete Rechtsgrundlage prüfen.
Auch Embeddings sind nicht automatisch anonym. Abhängig von Inhalt und Verknüpfbarkeit können sie weiterhin personenbezogene Daten darstellen. Eine lokale Datenbank oder ein selbst gehostetes KI-Modell kann die Kontrolle über Daten verbessern, ersetzt aber keine datenschutzrechtliche Prüfung.
Passendes Produkt in meinem Shop
KI ohne Bauchschmerzen
Zeigt kleinen Unternehmen Schritt für Schritt, wie sich KI inklusive Memory-Funktionen datenschutzbewusst und mit klaren internen Regeln einführen lässt.
Best Practices: So baust du ein zuverlässiges Agent-Gedächtnis auf
Für den produktiven Einsatz empfiehlt sich eine klare Memory-Strategie:
- Kurzzeit- und Langzeitdaten trennen: Aktuelle Gesprächsverläufe sollten nicht ungefiltert im dauerhaften Wissensspeicher landen.
- Erinnerungen mit Metadaten versehen: Jeder wichtige Memory-Eintrag sollte möglichst Informationen über Quelle, Erstellungszeitpunkt, Eigentümer, Gültigkeit und Vertrauenswürdigkeit enthalten.
- Sensible Informationen ausschließen: Passwörter, Tokens und andere Secrets gehören in geeignete Secret-Management-Systeme, nicht in den normalen Erinnerungsspeicher.
- Schreib- und Löschrechte begrenzen: Ein Agent sollte nicht beliebig seine eigenen Regeln oder kritische Betriebsinformationen verändern dürfen.
- Memory regelmäßig überprüfen: Veraltete oder widersprüchliche Informationen sollten erkannt und bereinigt werden.
- Kosten und Kontextgröße überwachen: Speicherung, Embedding-Erstellung, Suche und Kontextverarbeitung benötigen Ressourcen.
- Kritische Aktionen freigeben lassen: Auch ein Agent mit zuverlässigem Memory sollte produktive Änderungen nicht allein aufgrund früherer Erfahrungen ausführen.
Braucht jeder KI-Agent ein Langzeitgedächtnis?
Nein. Ein einfacher Agent, der einmalig eine PDF-Datei zusammenfasst, benötigt normalerweise keinen dauerhaften Memory-Speicher. Anders sieht es bei Systemen aus, die über Wochen oder Monate hinweg Aufgaben übernehmen. Typische Anwendungsfälle für Langzeit-Memory sind:
- IT-Support-Agenten mit Incident-Historie
- Persönliche Assistenten mit Nutzerpräferenzen
- Kundenservice-Agenten mit berechtigtem Zugriff auf Fallhistorien
- Coding-Agenten mit Projektwissen
- Automatisierungsagenten mit wiederkehrenden Workflows
Entscheidend ist nicht, möglichst viel zu speichern, sondern die richtigen Informationen zur richtigen Zeit bereitzustellen.
FAQ: Memory für KI-Agenten
Haben KI-Agenten ein echtes Gedächtnis?
KI-Agenten können Informationen speichern und später wiederverwenden. Das funktioniert technisch über Gesprächsverläufe, Datenbanken, Dokumente und Abrufmechanismen. Es ist nicht mit dem menschlichen Gedächtnis gleichzusetzen.
Was ist der Unterschied zwischen Short-Term und Long-Term Memory?
Short-Term Memory enthält Informationen für die aktuelle Unterhaltung oder Aufgabe. Long-Term Memory bewahrt ausgewählte Informationen über Sitzungen hinweg auf.
Ist eine Vektordatenbank für Agent Memory notwendig?
Nein. Viele Memory-Anwendungen lassen sich mit Redis, PostgreSQL, MariaDB oder Dateien umsetzen. Vektordatenbanken sind besonders für die semantische Suche nützlich.
Kann ein KI-Agent aus seinen Fehlern lernen?
Ein Agent kann Fehler und erfolgreiche Lösungen speichern und später berücksichtigen. Das ist jedoch nicht automatisch ein Training oder eine dauerhafte Veränderung des zugrunde liegenden Sprachmodells.
Was passiert, wenn der Kontextspeicher voll ist?
Wenn die zusammengestellten Informationen das Kontextfenster des Modells überschreiten, muss die Anwendung Inhalte kürzen, zusammenfassen oder gezielter auswählen. Andernfalls kann die Anfrage scheitern oder vom System abgewiesen werden.
Ist Agent Memory DSGVO-konform?
Memory kann datenschutzkonform umgesetzt werden, wenn die jeweilige Verarbeitung die rechtlichen Anforderungen erfüllt. Dazu gehören unter anderem eine Rechtsgrundlage, angemessene Sicherheitsmaßnahmen, Datenminimierung und Löschmöglichkeiten.
Quellen und Aktualitätsstand
Dieser Artikel berücksichtigt den Stand der offiziellen LangGraph-Dokumentation zu Short-Term- und Long-Term-Memory (Stand November 2026) sowie allgemeine, seit Jahren etablierte Grundlagen zu Vektordatenbanken und der Datenschutz-Grundverordnung. Als Primärquellen wurden insbesondere herangezogen: LangGraph-Dokumentation zu Memory, Qdrant, PostgreSQL-Dokumentation und die Datenschutz-Grundverordnung (EU) 2016/679.
Fazit: Gute KI-Agenten brauchen ein durchdachtes Gedächtnis
Memory ist eine wichtige Grundlage für KI-Agenten, die mehr leisten sollen als einmalige Fragen zu beantworten. Der Kurzzeitspeicher hält den aktuellen Arbeitsstand fest, der Langzeitspeicher bewahrt relevantes Wissen über längere Zeiträume, und die Kontextauswahl sorgt dafür, dass das Sprachmodell die passenden Informationen erhält. Erst das Zusammenspiel dieser Mechanismen ermöglicht Agenten, Aufgaben fortzusetzen, frühere Erfahrungen zu berücksichtigen und wiederkehrende Prozesse effizienter zu bearbeiten.
Dabei gilt: Mehr Memory bedeutet nicht automatisch bessere KI. Ein zuverlässiger KI-Agent benötigt vor allem korrekte, aktuelle und nachvollziehbare Informationen sowie klare Regeln für Speicherung, Zugriff und Löschung. Für Unternehmen, Entwickler und Systemadministratoren ist deshalb nicht nur die Auswahl des Sprachmodells entscheidend, sondern zunehmend auch die Architektur des dahinterliegenden Gedächtnisses.
Weiterführende Themen und Quellen
ChatGPT Memory richtig nutzen: Was sich ChatGPT merken kann – und was nicht (Zum Artikel)
MCP einfach erklärt: Was ist das Model Context Protocol? (Zum Artikel)
RAG für kleine Unternehmen: Wie KI endlich die eigenen Dokumente versteht (Zum Artikel)
Prompt Injection erklärt: Wie Angreifer KI-Agenten manipulieren (Zum Artikel)
Welche Rechte darf ein KI-Agent bekommen? Sicherheitsregeln für Agenten (Zum Artikel)
Stand: November 2026.